

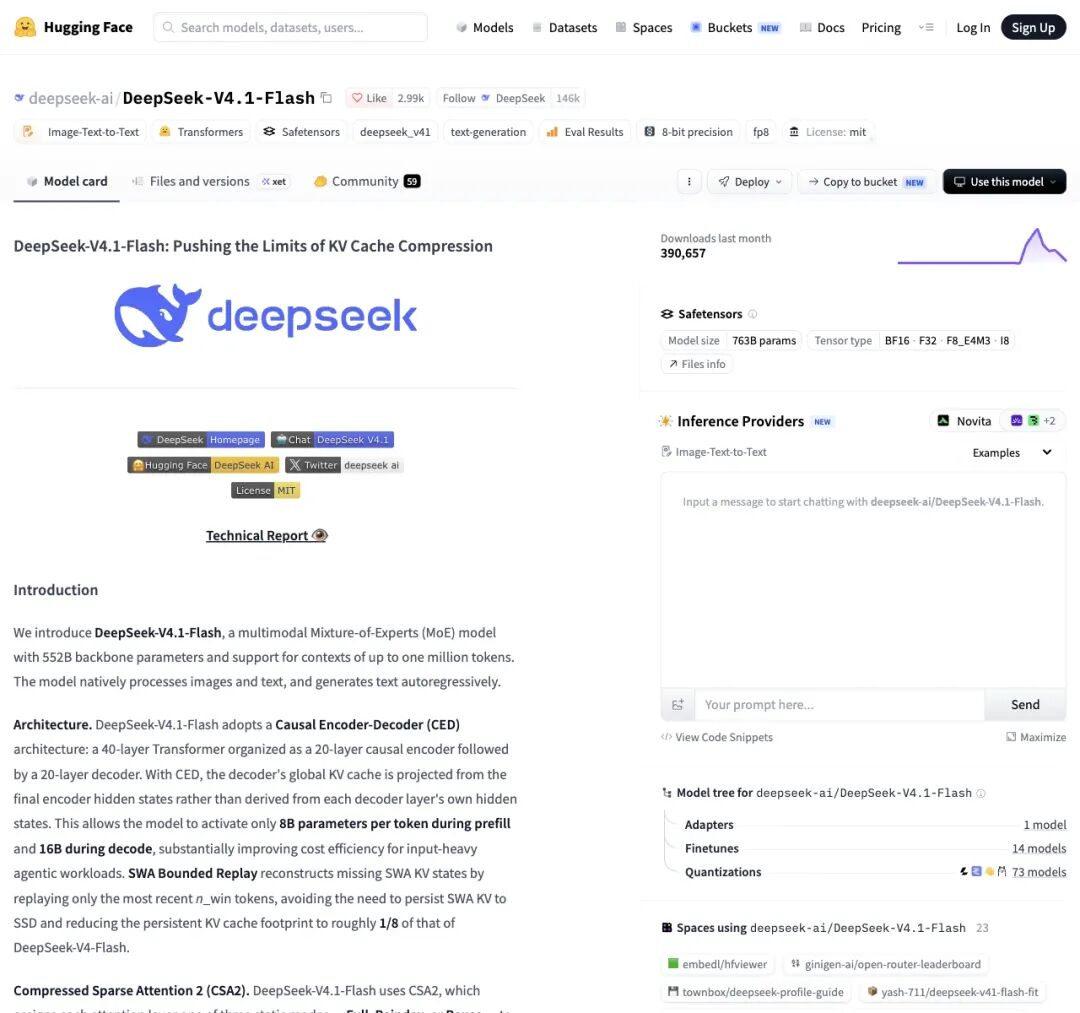
褪去所有多余的预热噱头,DeepSeek团队直接甩出了一篇干货满满的技术报告,并同步开源了全新模型,DeepSeek-V4.1-Flash。
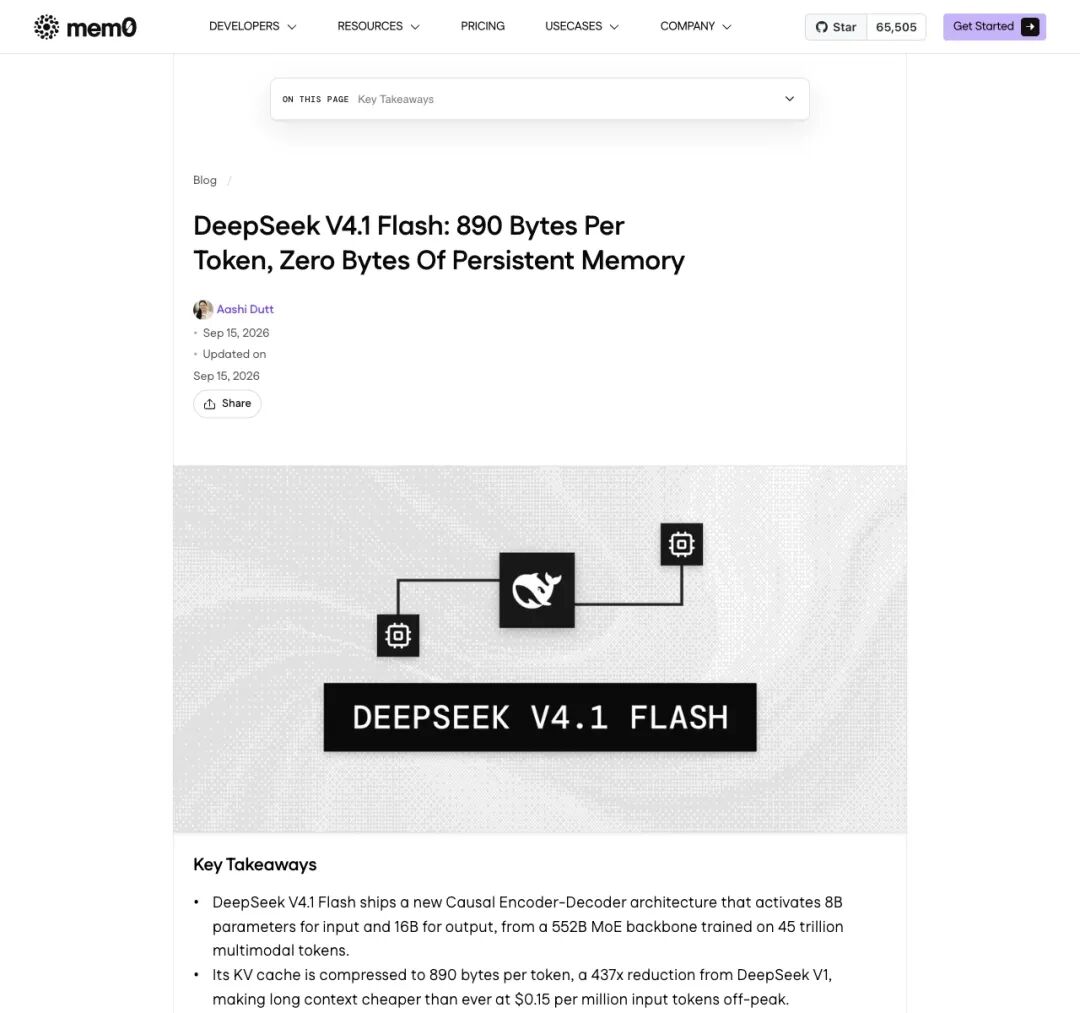
在工程实现层面,它的全局键值缓存(KV cache)直接被压缩到了令人瞠目结舌的890字节/Token。
谁也没想到,AI圈在深夜再次迎来一场大地震。
褪去所有多余的预热噱头,DeepSeek团队直接甩出了一篇干货满满的技术报告,并同步开源了全新模型,DeepSeek-V4.1-Flash。
主干参数约552B,外挂196B记忆参数;
原生支持100万 Token超长上下文;
直接在高达45万亿(45T)的多模态海量数据上从零开训!
在工程实现层面,它的全局键值缓存(KV cache)直接被压缩到了令人瞠目结舌的890字节/Token。
相比早期的初代模型,这个数字足足暴降了437倍!
整个技术社区彻底沸腾了
所有人都在讨论同一个焦点:明明架构发生了翻天覆地的重构,甚至能把百万上下文的推理成本砸穿地心,为什么改动如此剧烈的新模型只叫 4.1,却未直接命名为 DeepSeek-V5?
在聊它的精妙设计之前,我们必须先戳破大模型行业过去两年最大的一个痛点。
很多读者经常困惑:为什么各大厂商都在宣传“支持百万字输入”,但平时用起来,不仅速度缓慢,价格还居高不下?
问题的症结主要在算力之外,来自一块绝大多数普通人没听说过的暗礁,KV Cache(键值缓存)。
打个极通俗的比方:
大模型生成文字,就像一个作家在写长篇续作。
他每写一个字,并不需要把前面一百万字从头背一遍,而是把前面提炼出来的“核心剧情线索”随手记在一张便签上。
这张便签,就是KV Cache
你给模型的上下文越长,这张便签就越厚。
当你塞进几十万字的文档、代码库或者连续数十轮的Agent工具调用时,便签纸直接堆成了喜马拉雅山。
这些便签不能放在普通的硬盘里,必须死死霸占在最昂贵、最稀缺的GPU高带宽显存(HBM)里面。
结果就是:哪怕显卡的算力还没跑满,显存却早已被这些庞大的便签塞爆了。
带宽被挤干,多并发直接宕机
这就是为什么长文本服务一直是个“吞金巨兽”。
而 DeepSeek 这次的目标非常纯粹,甚至冷酷:不跟你卷虚无缥缈的刷分游戏,我要用手术刀般的架构创新,把内存与带宽的成本压到物理极限。
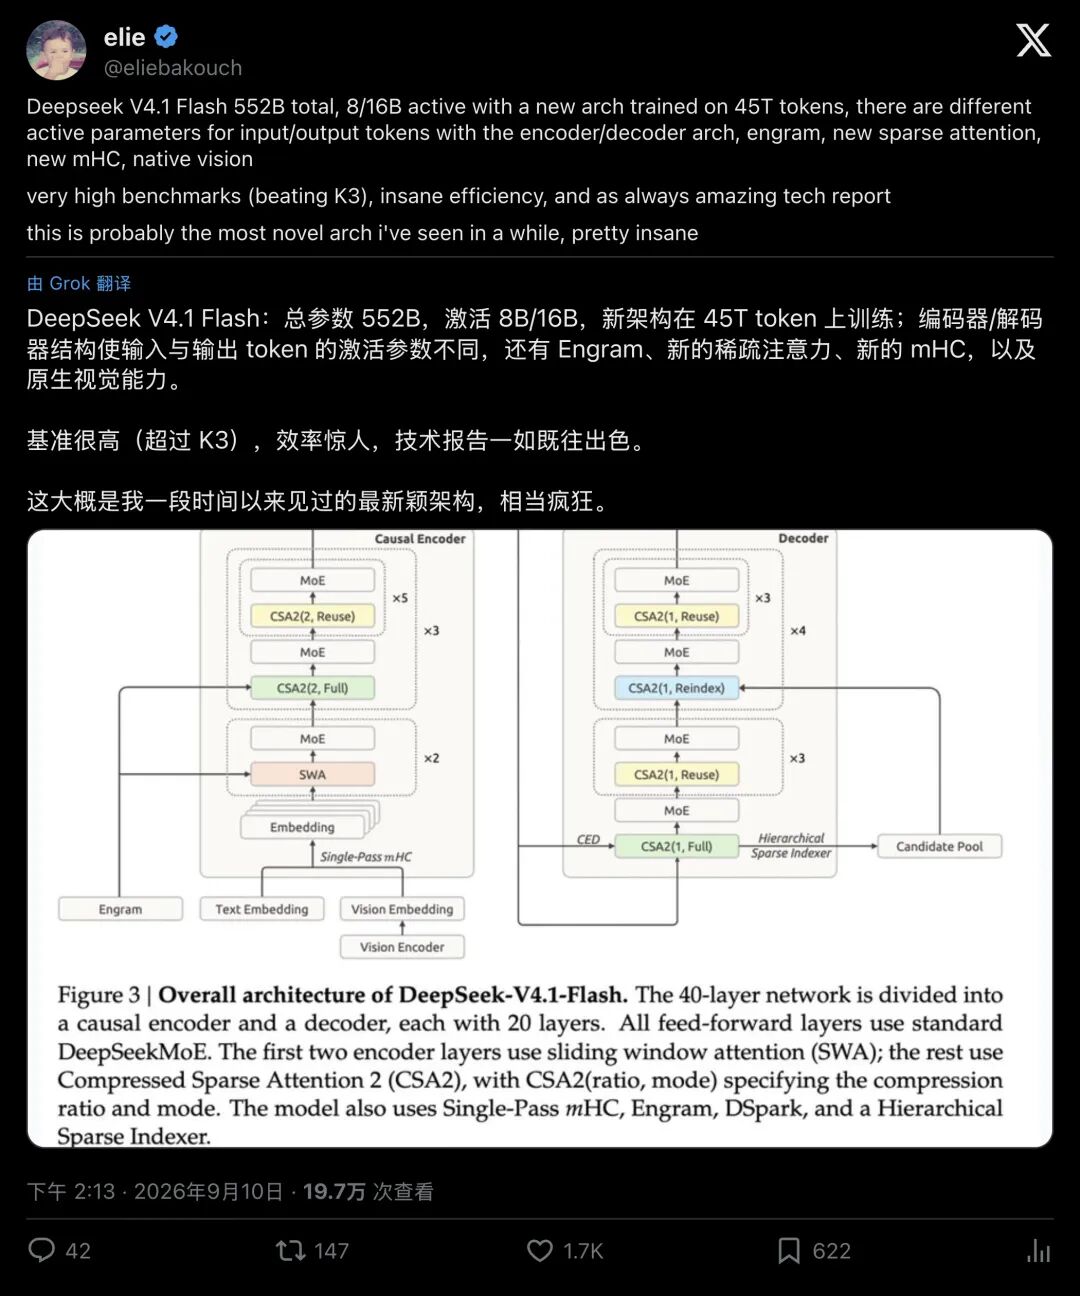
如果你翻开这次的架构设计图,第一眼就会被它的Causal Encoder-Decoder(因果编码器-解码器,简称 CED)所震撼。
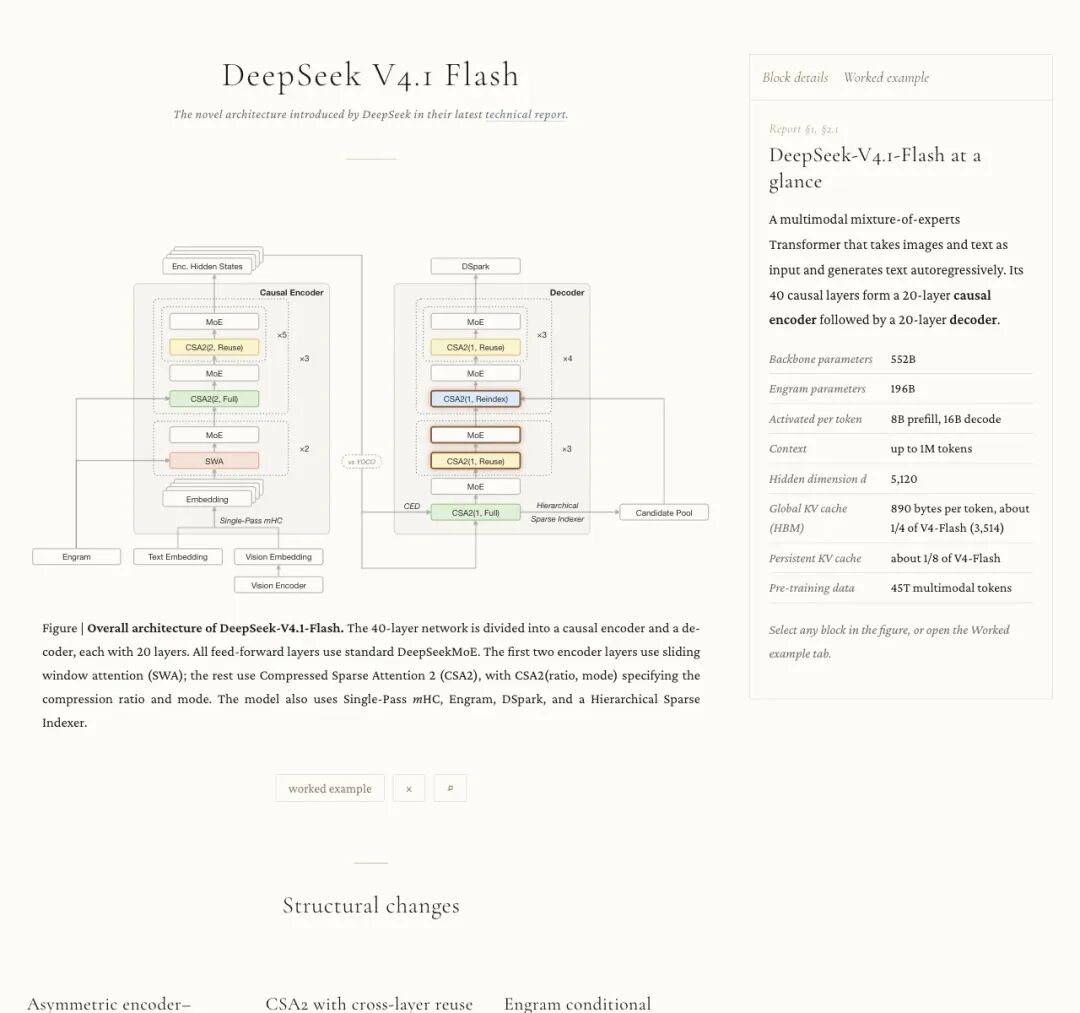
传统的语言模型通常是一条道走到黑,无论是读入你的长篇提示词(Prefill阶段),还是最后蹦出答案(Decode阶段),每一层都在消耗完全相同的计算量。
但 DeepSeek 团队反其道而行之:他们将模型拆成了40层,前20层是因果编码器,后20层是解码器。
这种拆分带来了一个极其漂亮的不对称效果:
1.当模型在阅读你的超长提示词(Prefill)时,每 Token 仅激活约8B(80亿)参数;
2.当模型开始思考并吐出回复(Decode)时,每 Token 才激活16B(160亿)参数。
这完全符合人类思考的生理直觉!
你看一本厚厚的参考资料时,大脑是在一目十行地快速扫描;
只有当你提起笔来写总结报告时,大脑才会全神贯注、火力全开。
对于当下的 AI Agent(智能体)工作流而言,这一刀堪称神来之笔。
因为Agent往往需要先吞下几万行的环境日志、网页代码,最后其实只输出几句工具调用指令。
用极其便宜的算力吞进海量信息,把最强的算力留给关键决策,成本直接被腰斩。
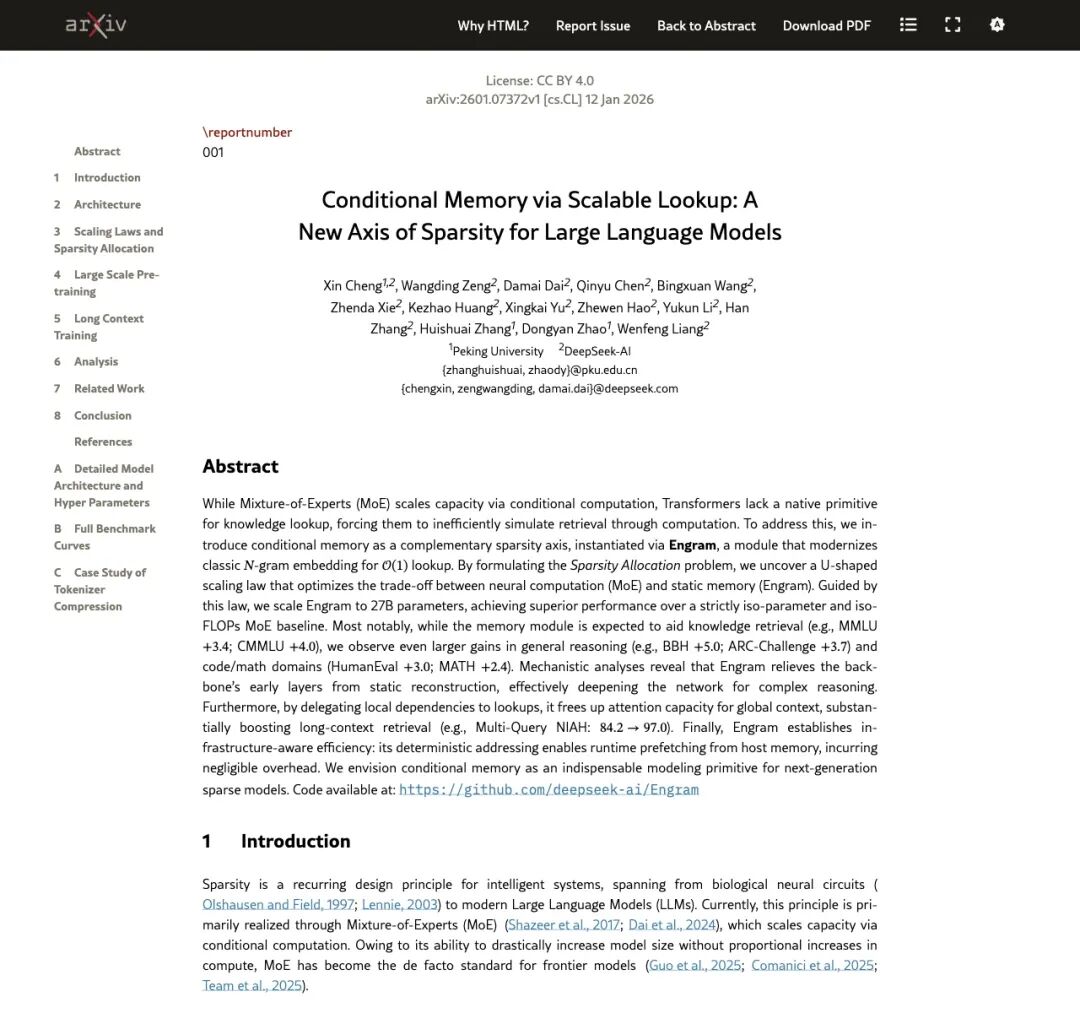
除了算力拆分,DeepSeek 还扔出了另一项大杀器,约196B参数的Engram 条件记忆模块。
过去的大语言模型,无论多么简单的常识(比如“地球绕着太阳转”),都需要在深层网络中通过大量的矩阵乘法去“算”出来。
这本质上是用极其昂贵的GPU算力,在做最廉价的死记硬背。
Engram 的逻辑极其暴力且优雅:既然是静态事实,为什么不用查表解决?
它利用现代化的 N-gram 哈希索引,直接把大量静态记忆固化到巨大的嵌入表中。
在推理时,以接近O(1)的极低复杂度瞬间捞取记忆,然后再与动态计算的思考状态融合。
架构设计的精妙之处在于,这196B的记忆参数根本不需要挤在昂贵的GPU显存里,完全可以存放在极其便宜的CPU内存(RAM)中!
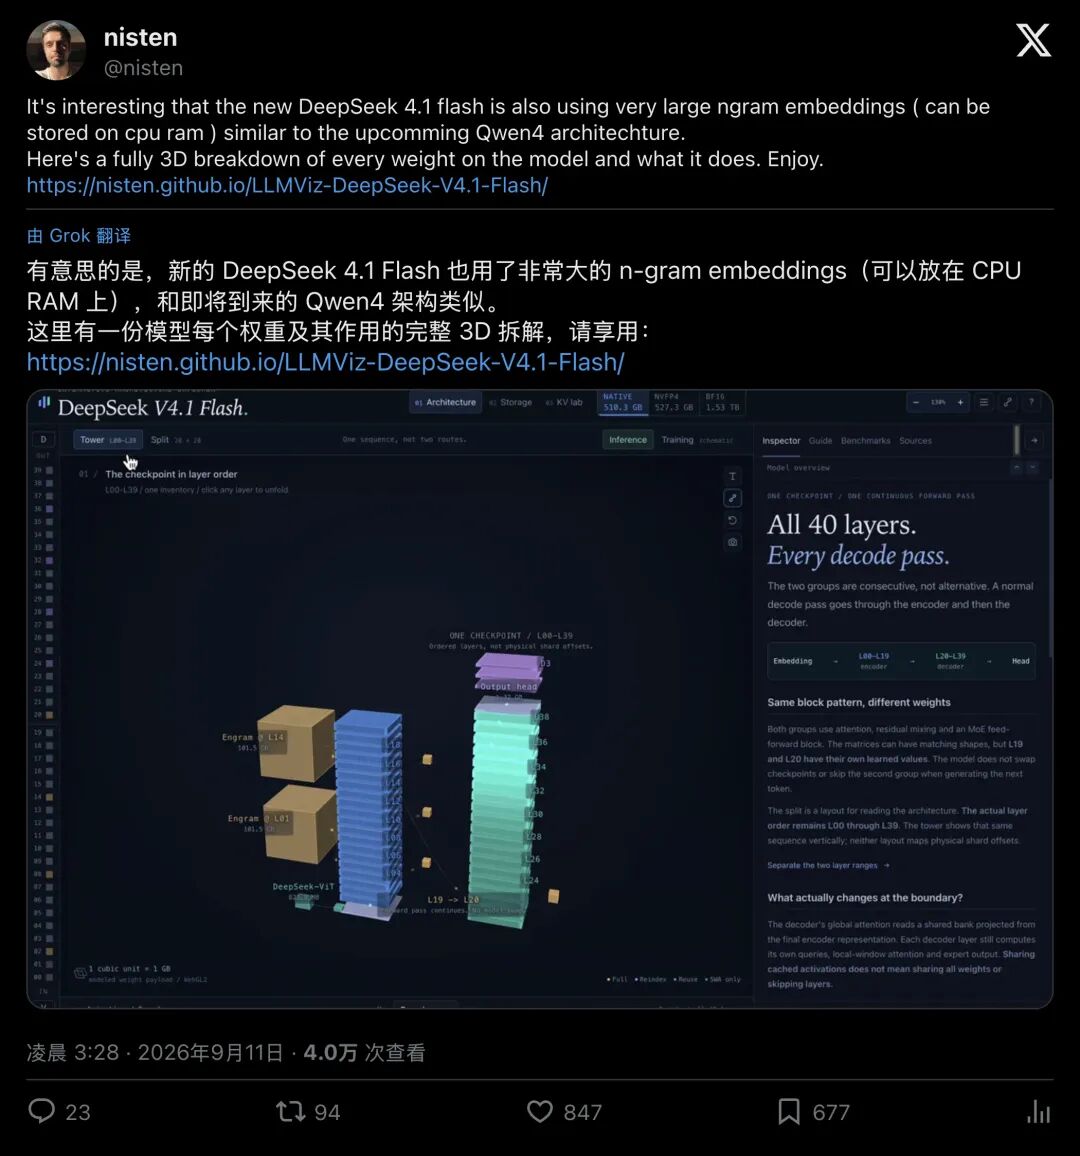
在GPU算力执行前,通过预取技术提前拉取记忆。
把深度留给推理,把记忆留给查表
这一设计直接打破了“所有模型参数必须死守显存”的行业铁律。
如果你以为这就结束了,那你就太小看 DeepSeek 的工程狠劲了。
在底层的残差连接上,他们改进了此前备受关注的mHC(流形约束超连接)。
传统残差连接就像单车道公路,所有信息只能顺着一条线往下走;
mHC则把道路拓宽为多条并行车道,让信息流大幅增强,模型在极深层数下依然极度稳定。
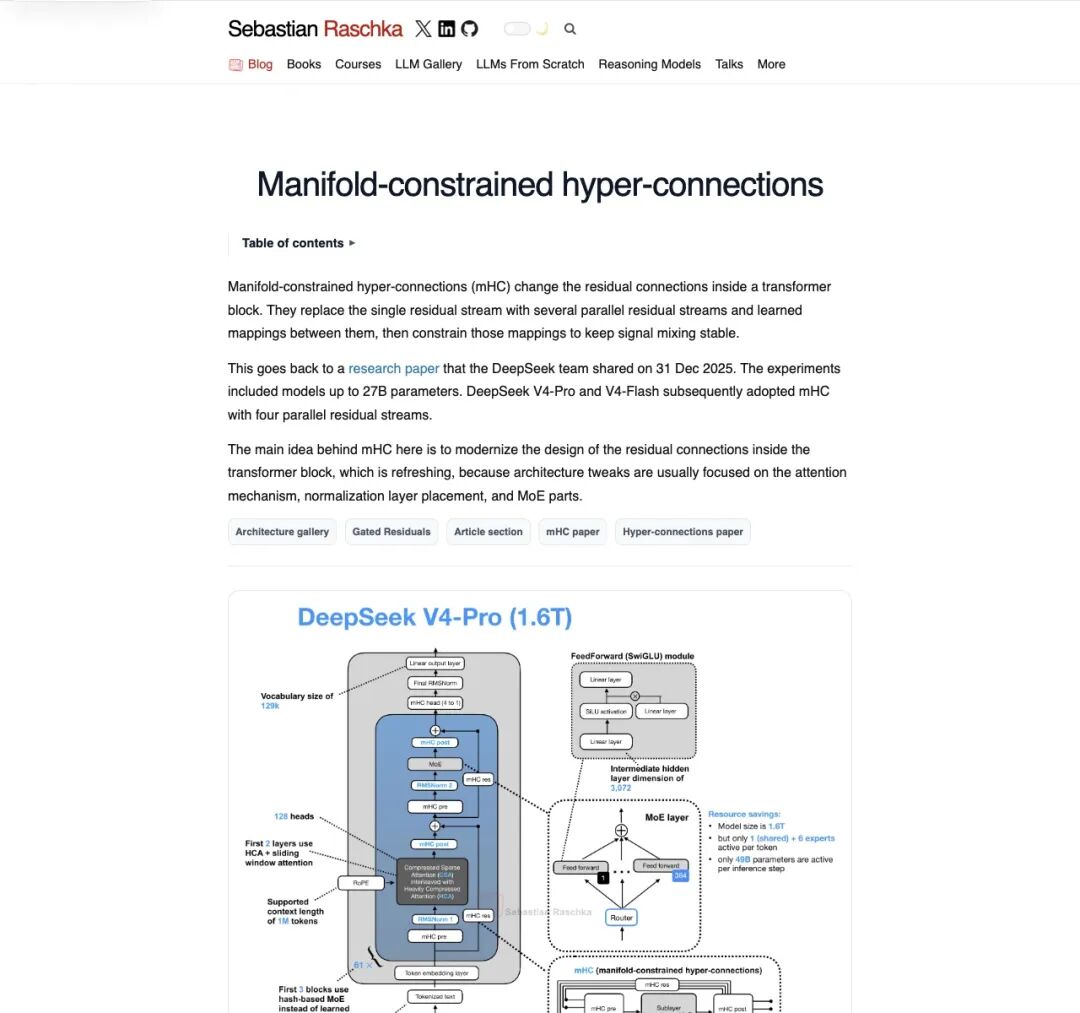
而在V4.1中,他们实现了Single-Pass mHC。
在底层算子层面,以往需要多次在芯片片上缓存与显存之间来回倒腾数据的繁琐步骤,被直接改写成了一趟通到底的极简流。
少付一半的访存税,推理速度再次起飞。
再加上全新的CSA2(压缩稀疏注意力2代),模型实现了跨层复用全局KV和稀疏索引;
主 KV cache 更是直接应用了FP4低精度量化与SWA Bounded Replay(滑动窗口近似回放)。
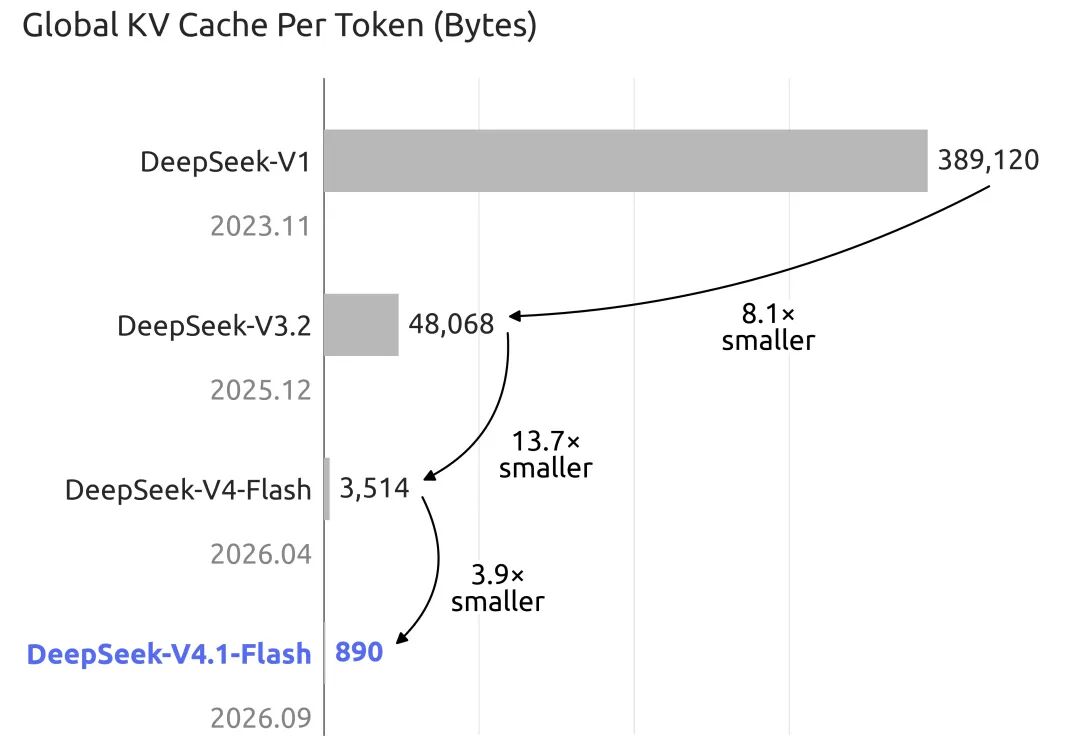
所有的工程组合拳叠加在一起,最终铸就了这个奇迹般的数字:890 Bytes / Token。
相比曾经动辄几万字节每 Token 的庞然大物,现在的显存开销被硬生生削去了一个数量级以上。
这是一套彻底面向工业级落地打造的生产力架构。
为了打造这个架构,DeepSeek 在45万亿多模态Token上进行了扎扎实实的全量从零预训练。
训练一开始就直接在64K序列长度上启动,并在约34TToken 处直接拓宽到100万(1M)极限上下文。
在实际能力上,V4.1-Flash 不仅原生融合了视觉多模态,更在各类复杂的 Agent、代码编写和长程逻辑推理基准中,展现出了几乎可以逼近甚至持平此前更大尺寸 Pro 版本的凶悍战斗力。
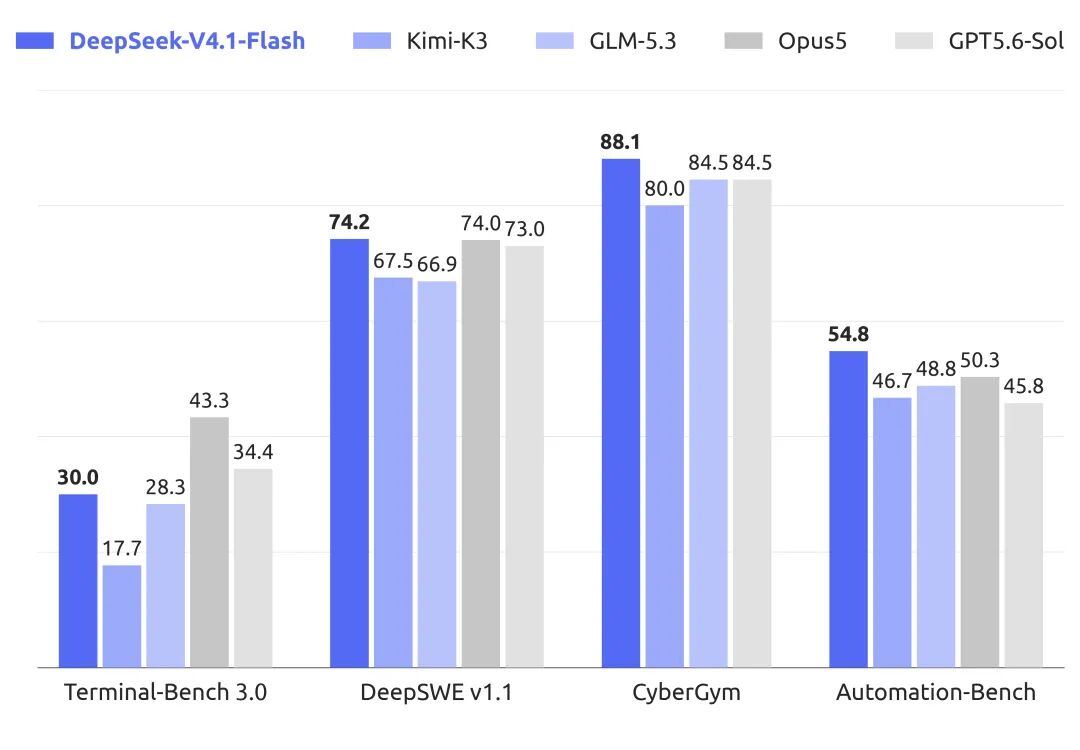
甚至在推理时,它还贴心地提供了1到100档可调节的 reasoning effort(思考力度),让开发者能够自由在响应速度与极致深思之间自由切换。
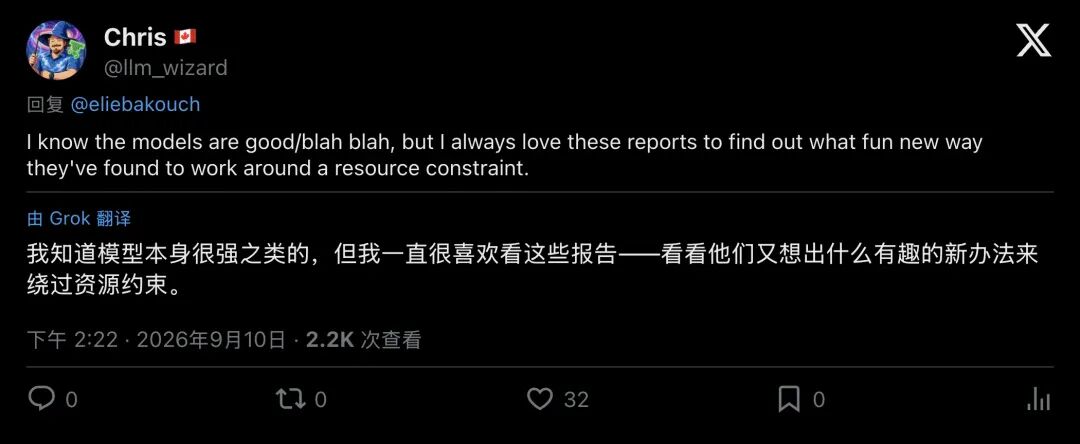
一位海外资深工程师在看完技术报告后,发出了发自内心的感慨:
回顾整场大模型的发展史,我们会发现评判的标准正在悄然换轨。
2023年,行业在盲目攀比“谁的参数更大”;
2024年,大家在比拼“谁的上下文窗口标称更长”;
而到了今天,行业核心命题变成了:谁能把百万上下文的并发成本,降到人人可用、每家企业都部署得起的工业级水准?
DeepSeek-V4.1-Flash 的发布,就像在平静的湖面投下了一颗万吨水雷。
它证明了一件事:算力的摩尔定律或许在放缓,但算法与系统协同设计的进化,才刚刚拉开大幕。
当长上下文的显存账单被打成平价基建,高并发、长程复杂的自主智能体(Agent)时代,才算迎来了破晓时刻!

(整理编辑:Kai)
 京公网安备11010502056287号